OpenAI Devs:为40个区域超12亿用户提供毫秒级数据服务
OpenAI Devs 表示其数据服务覆盖40个地理区域、服务超12亿用户,并与 Azure Cosmos DB 合作将全球读取延迟中位数改善12倍。
原贴
查看原文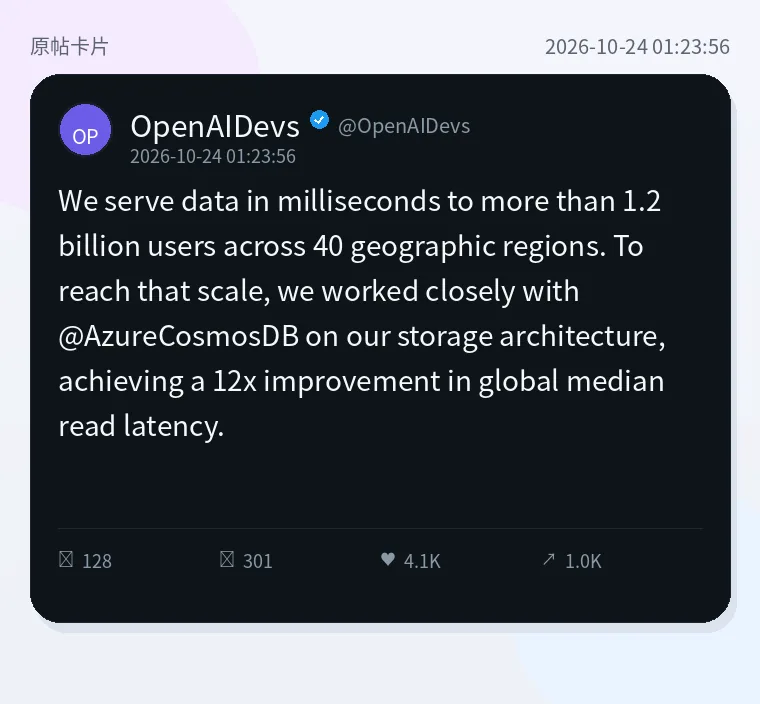
原文
中文翻译
我们在40个地理区域为超过12亿用户提供毫秒级的数据服务。
为达到这一规模,我们与 @AzureCosmosDB 在存储架构上紧密合作,使全球读取延迟中位数改善了12倍。
核心信息
OpenAI Devs 表示其数据服务覆盖40个地理区域、服务超12亿用户,并与 Azure Cosmos DB 合作将全球读取延迟中位数改善12倍。
- OpenAI Devs 表示其数据服务覆盖40个地理区域、服务超12亿用户,并与 Azure Cosmos DB 合作将全球读取延迟中位数改善12倍。
- 原贴提到:We serve data in milliseconds to more than 1.2 billion users across 40 g
- 来源:x.com
详细解读
这是什么信号:OpenAI Devs 公开披露,其数据服务在40个地理区域为超过12亿用户提供毫秒级响应,并与 Azure Cosmos DB 在存储架构上合作,使全球读取延迟中位数改善12倍。这不是单个模型能力更新,而是面向全球规模的数据读取基础设施能力展示。
为什么重要:当 AI 产品从 Demo 走向多区域用户,读延迟会直接影响首屏、会话恢复、工具调用和状态读取体验。12倍中位数改善说明存储层与区域架构可能成为规模化体验的关键变量;但中位数不等于尾延迟,不能直接推导所有请求都达到毫秒级。
对谁有价值:对做全球化 AI 应用、实时协作、Agent 状态存储、账号/配置/会话读取的团队最有参考价值;对基础设施与平台团队,它提示应把多区域存储、读路径隔离和延迟指标纳入架构评审。
可以怎么行动:先按区域拆分读延迟的 p50/p95/p99,确认瓶颈在存储、跨区调用还是应用层;再评估多区域复制、读写分离、热点数据本地化与一致性取舍;对关键读路径建立以中位数和尾延迟并重的持续压测,而不是只看平均响应。
风险或限制:公开信号没有披露具体工作负载、数据模型、一致性级别、成本变化和压测条件,也没有给出 p95/p99 数据;与特定云存储服务的深度合作经验不一定可平移到其他技术栈。12倍改善应作为方向性参考,落地前需用自己的流量模型验证。
信息差价值
这条内容的真正价值,不只是“有人发布了一个新功能”,而是它揭示了 x.com 背后的产品方向、工作流变化或竞争信号。对 OPC 来说,这种信息可以转化成持续追踪的栏目选题。
如果把《OpenAI Devs:为40个区域超12亿用户提供毫秒级数据服务》放到你的内容系统里,它最大的价值在于帮助读者更快看懂“为什么值得关注”,而不是只看到一条碎片化动态。
参考来源
TOPIC HUBS
延伸专题
AI SUMMARY
这篇文章回答了什么
OpenAI Devs:为40个区域超12亿用户提供毫秒级数据服务主要讲什么?
OpenAI Devs 表示其数据服务覆盖40个地理区域、服务超12亿用户,并与 Azure Cosmos DB 合作将全球读取延迟中位数改善12倍。
这篇文章最值得关注的要点是什么?
OpenAI Devs 表示其数据服务覆盖40个地理区域、服务超12亿用户,并与 Azure Cosmos DB 合作将全球读取延迟中位数改善12倍。;原贴提到:We serve data in milliseconds to more than 1.2 billion users across 40 g;来源:x.com
这篇文章和哪些AI专题相关?
它适合放在AI日报、AI工具、Agent工作流专题里阅读。 关联原因:这篇内容命中「热点解读」等主题信号。;这篇内容来自该专题长期覆盖的栏目。;这篇内容来自该专题长期覆盖的栏目。
阅读这篇文章建议先理解哪些关键词?
建议先理解AI日报、每日AI日报、AI信号、热点解读、BuilderPulse这些关键词,再结合正文判断工具、机会或风险是否值得进入自己的工作流。