Arena 评测:Claude Sonnet 5.5 登顶 Agent Arena 第 3 名但未入 Pareto 前沿
Agent Arena 最新榜单显示,Claude Sonnet 5.5 以 +12.5% 净提升排名第 3,单任务中位成本 $2.74,比排名第 2 的 Claude Opus 5.5($1.58)高出约 73%,且后者得分更高,因此 Sonnet 5.5 未进入 Pareto 前沿;但在 Chat 类目它以 +15.6% 排名第 1,Anthropic 模型包揽前三。
原贴
查看原文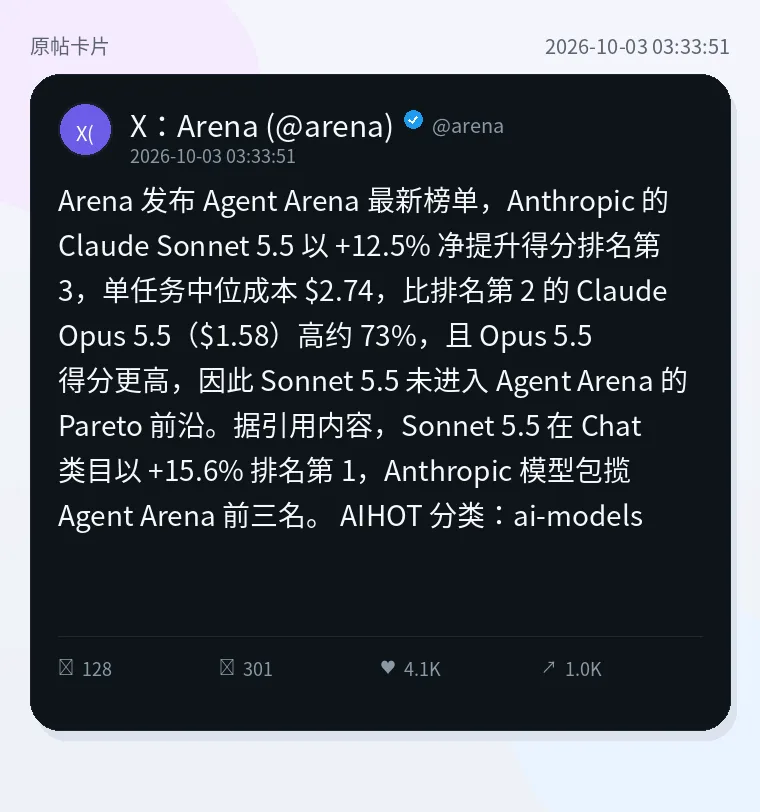
原文
中文翻译
Arena 发布 Agent Arena 最新榜单,Anthropic 的 Claude Sonnet 5.5 以 +12.5% 净提升得分排名第 3,单任务中位成本 $2.74,比排名第 2 的 Claude Opus 5.5($1.58)高约 73%,且 Opus 5.5 得分更高,因此 Sonnet 5.5 未进入 Agent Arena 的 Pareto 前沿。
据引用内容,Sonnet 5.5 在 Chat 类目以 +15.6% 排名第 1,Anthropic 模型包揽 Agent Arena 前三名。
核心信息
Agent Arena 最新榜单显示,Claude Sonnet 5.5 以 +12.5% 净提升排名第 3,单任务中位成本 $2.74,比排名第 2 的 Claude Opus 5.5($1.58)高出约 73%,且后者得分更高,因此 Sonnet 5.5 未进入 Pareto 前沿;但在 Chat 类目它以 +15.6% 排名第 1,Anthropic 模型包揽前三。
- Agent Arena 最新榜单显示,Claude Sonnet 5.5 以 +12.5% 净提升排名第 3,单任务中位成本 $2.74,比排名第 2 的 Claude Opus 5.5($1.58)高出约 73%,且后者得分更高,因此 Sonnet 5.5 未进入 Pareto 前沿;但在 Chat 类目它以 +15.6% 排名第 1,Anthropic 模型包揽前三。
- 原贴提到:Arena 发布 Agent Arena 最新榜单,Anthropic 的 Claude Sonnet 5.5 以 +12.5% 净提升得分排名
- 来源:x.com
详细解读
这是什么信号
Agent Arena 是一次针对智能体(Agent)任务的横向评测。这一次榜单给出三个关键事实:Claude Sonnet 5.5 以 +12.5% 的净提升排在第 3;它的单任务中位成本是 $2.74;同门的 Claude Opus 5.5 排在第 2,成本 $1.58,得分还更高。三者叠加的直接结论是:Sonnet 5.5 被同厂模型在“分数更高、成本更低”两个维度同时压制,因此没有进入该榜单的 Pareto 前沿。
“没进 Pareto 前沿”不等于“模型不行”,它的准确含义是:在当前的得分—成本坐标系里,存在一个在两项指标上都不劣于它的选项。这是评测机构用性价比视角给出的排序语言,而不是能力上限的判断。
为什么重要
过去一年模型选型的默认逻辑是“谁分数高用谁”,但 Agent 场景的成本结构与对话场景完全不同:一次任务往往包含多轮工具调用、自我修正和重试,单任务成本会被放大成实实在在的账单。当同一家厂商的两代模型出现“更强的那个反而更便宜”时,说明单纯按代际或按名字挑模型的策略已经失效。
另一个值得注意的细节是类目分化:Sonnet 5.5 在 Chat 类目以 +15.6% 排第 1,在 Agent 类目却退到第 3。这提示“通用能力领先”和“Agent 任务领先”并不是同一件事,评测类目本身就是选型信息的一部分。
同时,Anthropic 模型包揽 Agent Arena 前三,意味着在 Agent 这个细分战场上的竞争格局比整体榜单更集中。
对谁有价值
- 正在做 Agent 产品的团队:这条信号直接影响路由策略和成本模型,尤其是把“默认模型”设成单一型号的团队。
- 做模型选型与评测的人:Pareto 前沿这个概念比单点排名更值得纳入内部评测流程。
- 控制 API 预算的负责人:中位成本 $2.74 与 $1.58 之间的差距,乘以调用量就是可量化的采购决策依据。
- 关注竞争格局的从业者:前三名被同一家占据,是一个值得持续跟踪的结构性信号。
可以怎么行动
第一,把 Pareto 前沿的思路搬进自己的评测:不要只记录分数,而是把分数和单任务成本画在同一张二维图上,找出自己业务权重下的最优解。第二,按类目而不是按模型名做选型——Chat 类任务和 Agent 类任务可以走不同的默认模型。第三,对成本敏感的长链路任务做一次实测抽样,用自己的真实调用分布去验证榜单里的中位成本是否成立,因为中位数未必等于你的分布。
第四,如果已在用 Sonnet 5.5,不必因为这次排名立即切换,但值得设置一个明确的复评触发点:当某任务的单位成本或成功率出现偏差时,再对照榜单做一次 A/B。
风险与限制
需要注意,本条信息的原始信号只包含排名、净提升幅度和单任务中位成本,没有披露评测任务集构成、样本量、通过标准以及成本的计算口径。中位成本对长尾任务尤其敏感,如果你的任务结构与评测集差异较大,结论可能不成立。此外,榜单是一次性快照,模型版本、推理配置和价格都可能变化,据此做出的选型决策应保留复评机制。
信息差价值
这条内容的真正价值,不只是“有人发布了一个新功能”,而是它揭示了 x.com 背后的产品方向、工作流变化或竞争信号。对 OPC 来说,这种信息可以转化成持续追踪的栏目选题。
如果把《Arena 评测:Claude Sonnet 5.5 登顶 Agent Arena 第 3 名但未入 Pareto 前沿》放到你的内容系统里,它最大的价值在于帮助读者更快看懂“为什么值得关注”,而不是只看到一条碎片化动态。
参考来源
TOPIC HUBS
延伸专题
AI SUMMARY
这篇文章回答了什么
Arena 评测:Claude Sonnet 5.5 登顶 Agent Arena 第 3 名但未入 Pareto 前沿主要讲什么?
Agent Arena 最新榜单显示,Claude Sonnet 5.5 以 +12.5% 净提升排名第 3,单任务中位成本 $2.74,比排名第 2 的 Claude Opus 5.5($1.58)高出约 73%,且后者得分更高,因此 Sonnet 5.5 未进入 Pareto 前沿;但在 Chat 类目它以 +15.6% 排名第 1,Anthropic…
这篇文章最值得关注的要点是什么?
Agent Arena 最新榜单显示,Claude Sonnet 5.5 以 +12.5% 净提升排名第 3,单任务中位成本 $2.74,比排名第 2 的 Claude Opus 5.5($1.58)高出约 73%,且后者得分更高,因此…;原贴提到:Arena 发布 Agent Arena 最新榜单,Anthropic 的 Claude Sonnet 5.5 以 +12.5% 净提升得分排名;来源:x.com
这篇文章和哪些AI专题相关?
它适合放在Agent工作流、AI工具、AI日报专题里阅读。 关联原因:这篇内容命中「Agent」等主题信号。;这篇内容命中「模型、Claude」等主题信号。;这篇内容命中「热点解读」等主题信号。
阅读这篇文章建议先理解哪些关键词?
建议先理解AI日报、每日AI日报、AI信号、热点解读、BuilderPulse这些关键词,再结合正文判断工具、机会或风险是否值得进入自己的工作流。