GPT-Live-1 在 Tau3 客户支持任务上首轮完成率 83.6%
公开信号显示,Tau3 用来检验语音智能体能否真正完成航空、零售、电信三类场景的客户支持任务。与以中等推理强度运行的 GPT-6 Astra 搭配时,GPT-Live-1 首次尝试即完成 83.6% 的任务。原文在“compared”处被截断,对比对象、样本量与评测口径均未给出。这条信号的价值在于把语音智能体的评价重心从“像不像人说话”拉回到“能不能把事办完”。
原贴
查看原文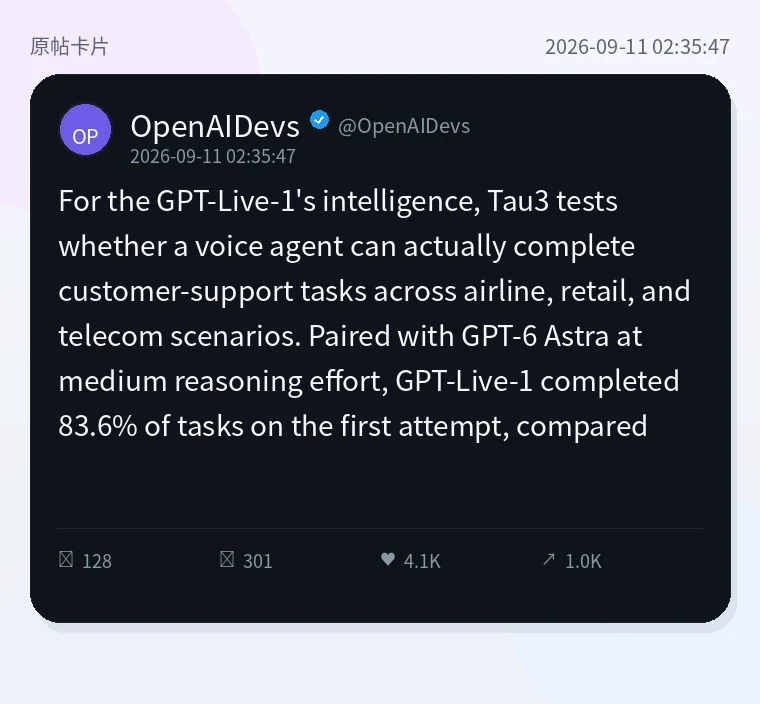
原文
中文翻译
就 GPT-Live-1 的智能水平而言,Tau3 测试的是一款语音智能体能否真正在航空、零售和电信场景中完成客户支持任务。
与以中等推理强度运行的 GPT-6 Astra 搭配时,GPT-Live-1 首次尝试即完成了 83.6% 的任务,相比
核心信息
公开信号显示,Tau3 用来检验语音智能体能否真正完成航空、零售、电信三类场景的客户支持任务。与以中等推理强度运行的 GPT-6 Astra 搭配时,GPT-Live-1 首次尝试即完成 83.6% 的任务。原文在“compared”处被截断,对比对象、样本量与评测口径均未给出。这条信号的价值在于把语音智能体的评价重心从“像不像人说话”拉回到“能不能把事办完”。
- 公开信号显示,Tau3 用来检验语音智能体能否真正完成航空、零售、电信三类场景的客户支持任务。与以中等推理强度运行的 GPT-6 Astra 搭配时,GPT-Live-1 首次尝试即完成 83.6% 的任务。原文在“compared”处被截断,对比对象、样本量与评测口径均未给出。这条信号的价值在于把语音智能体的评价重心从“像不像人说话”拉回到“能不能把事办完”。
- 原贴提到:For the GPT-Live-1's intelligence, Tau3 tests whether a voice agent can
- 来源:x.com
详细解读
这是什么信号
@OpenAIDevs 释放的是一条评测型信号:Tau3 的定位不是测语音质量,而是测语音智能体能否在航空、零售、电信这三类客户支持场景中把任务真正跑完。给出的关键数字是——在与 GPT-6 Astra(中等推理强度)搭配时,GPT-Live-1 首次尝试就完成了 83.6% 的任务。
需要明确的是,原文在“compared”处中断,对照对象、任务总量、失败定义、是否允许重试这些决定数字含金量的信息全部缺失。因此这条信号的正确读法是“方向性证据”,而不是“结论性数据”。
为什么重要
- 评价坐标换了。语音 Agent 过去被拿去比语音自然度、打断响应、音色拟人度,这些都是体验层指标。Tau3 把标尺换成任务完成率,意味着衡量标准变成“事办没办成”。
- “首次尝试”这个限定词很关键。首轮完成率反映的是一次交互内闭环的能力,而不是靠反复澄清、多轮重试或转人工兜底堆出来的成功率。首轮完成率的提升通常直接对应通话时长和客服成本的下降。
- 场景选择有含义。航空(改签、退票、行李、里程)、零售(订单、退换、物流)、电信(套餐、故障、账单)是流程最长、系统集成最重、合规约束最密的三个客服品类。选它们做测试,说明评测在往真实业务摩擦上靠,而不是停在演示环境。
- 架构信息藏在组合里。“语音模型 + 更强推理模型、中等推理强度”被明确写出来,说明语音正在被当作实时交互层,而复杂决策交给后端推理模型——这是可直接借用的产品分层思路。
对谁有价值
- 做客服系统、呼叫中心、BPO 替代方案的团队:这是一个可直接对标的当期水位线。
- 语音 Agent 创业者:判断自己该补的是语音管线还是任务规划与工具调用能力。
- 企业客户体验负责人与采购:评估供应商时,可以把“首轮任务完成率”写进验收指标,而不是只看 Demo 演示。
- 模型应用工程师:关注推理强度与延迟、成本之间的取舍点。
可以怎么行动
- 先补齐缺失信息再引用:对比基线是谁、任务集规模多大、失败样本集中在哪类意图。
- 做小样本自测。从自有工单里挑 10–20 条高频任务,覆盖航空/零售/电信式的多步流程,只统计“首轮无人工介入完成率”,得到自己的基线。
- 把 83.6% 拆成结构:哪类任务易过、哪类必挂,往往比总分更能指导产品设计。
- 按任务复杂度分配模型档位,对简单意图用低推理强度压延迟和成本,把高推理强度留给多步改签、跨系统查询这类硬任务。
- 提前设计人工兜底与升级路径,把剩余失败率当作产品的一部分来承接。
风险与限制
- 原文被截断,最重要的对比项缺失,任何“提升了多少”的结论都不成立。
- 首轮完成率不等于端到端解决率,更不等于客户满意度;客户可能完成了任务但体验很差。
- 任务完成率的定义高度依赖评测方:单步任务与跨系统多步任务的难度差异极大,跨评测不可直接比较。
- 由模型提供方或其开发者账号发布的评测存在选择性披露的可能,需要第三方复现。
- 三类场景以外的行业(医疗、金融合规流程等)不能据此外推,工具生态与权限约束完全不同。
信息差价值
这条内容的真正价值,不只是“有人发布了一个新功能”,而是它揭示了 x.com 背后的产品方向、工作流变化或竞争信号。对 OPC 来说,这种信息可以转化成持续追踪的栏目选题。
如果把《GPT-Live-1 在 Tau3 客户支持任务上首轮完成率 83.6%》放到你的内容系统里,它最大的价值在于帮助读者更快看懂“为什么值得关注”,而不是只看到一条碎片化动态。
参考来源
TOPIC HUBS
延伸专题
AI SUMMARY
这篇文章回答了什么
GPT-Live-1 在 Tau3 客户支持任务上首轮完成率 83.6%主要讲什么?
公开信号显示,Tau3 用来检验语音智能体能否真正完成航空、零售、电信三类场景的客户支持任务。与以中等推理强度运行的 GPT-6 Astra 搭配时,GPT-Live-1 首次尝试即完成 83.6% 的任务。原文在“compared”处被截断,对比对象、样本量与评测口径均未给出。这条信号的价值在于把语音智能体的评价重心从“像不像人说话”拉回到“能不能把事办…
这篇文章最值得关注的要点是什么?
公开信号显示,Tau3 用来检验语音智能体能否真正完成航空、零售、电信三类场景的客户支持任务。与以中等推理强度运行的 GPT-6 Astra 搭配时,GPT-Live-1 首次尝试即完成 83.6% 的任务。原文在“compared”处被…;原贴提到:For the GPT-Live-1's intelligence, Tau3 tests whether a voice agent can;来源:x.com
这篇文章和哪些AI专题相关?
它适合放在Agent工作流、AI工具、AI日报专题里阅读。 关联原因:这篇内容命中「Agent、智能体」等主题信号。;这篇内容命中「自动化、模型」等主题信号。;这篇内容命中「热点解读」等主题信号。
阅读这篇文章建议先理解哪些关键词?
建议先理解AI日报、每日AI日报、AI信号、热点解读、BuilderPulse这些关键词,再结合正文判断工具、机会或风险是否值得进入自己的工作流。