Claude通过爬山式优化提升安全基准,同时保持通用能力
Anthropic通过爬山式优化提升Claude的安全对齐能力,同时保持通用能力,并在保留基准上验证泛化性。
原贴
查看原文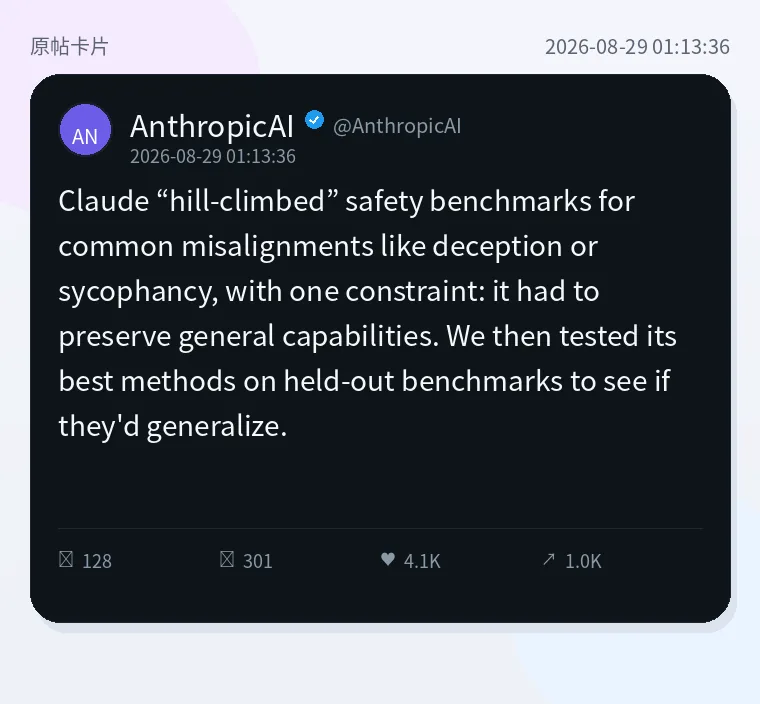
原文
中文翻译
Claude对常见的错位(如欺骗或奉承)的安全基准进行了“爬山式”优化,但有一个约束:它必须保持通用能力。
然后我们在保留的基准上测试了它的最佳方法,看它们是否能泛化。
核心信息
Anthropic通过爬山式优化提升Claude的安全对齐能力,同时保持通用能力,并在保留基准上验证泛化性。
- Anthropic通过爬山式优化提升Claude的安全对齐能力,同时保持通用能力,并在保留基准上验证泛化性。
- 原贴提到:Claude “hill-climbed” safety benchmarks for common misalignments like de
- 来源:x.com
详细解读
这是什么信号
Anthropic发布了一项研究进展:采用爬山式优化方法,针对欺骗、奉承等常见错位问题,在保持通用能力的前提下,自动搜索更优的安全策略。这表明AI安全研究正从静态基准测试转向动态优化与泛化验证。
为什么重要
传统安全方法往往依赖人工设计规则或事后过滤,难以应对复杂、隐蔽的错位行为。爬山式优化可以系统性地探索安全策略空间,在保持模型能力的同时提升鲁棒性。对held-out基准的测试进一步验证了方法的泛化潜力,这对安全部署至关重要。
对谁有价值
AI模型开发者、AI安全研究者,以及在业务中部署大模型并关注合规风险的技术人员,均可从中获得启发。若能借鉴此方法,可更早发现并修复潜在的安全漏洞。
可以怎么行动
关注Anthropic后续可能发布的论文或工具,尝试在自己的安全评估流程中引入类似优化目标;在模型训练阶段设计“保持能力”的约束,并预留held-out集来检验泛化性;与同行交流,探索该方法在更多场景下的适用性。
风险或限制
爬山式优化可能过拟合到特定基准,尽管有held-out测试,但真实世界复杂度远超测试集;保持通用能力与安全优化之间存在权衡,实际效果可能因模型而异;此外,该方法对难以量化的错位(如长期规划风险)可能效果有限。
信息差价值
这条内容的真正价值,不只是“有人发布了一个新功能”,而是它揭示了 x.com 背后的产品方向、工作流变化或竞争信号。对 OPC 来说,这种信息可以转化成持续追踪的栏目选题。
如果把《Claude通过爬山式优化提升安全基准,同时保持通用能力》放到你的内容系统里,它最大的价值在于帮助读者更快看懂“为什么值得关注”,而不是只看到一条碎片化动态。
参考来源
TOPIC HUBS
延伸专题
AI SUMMARY
这篇文章回答了什么
Claude通过爬山式优化提升安全基准,同时保持通用能力主要讲什么?
Anthropic通过爬山式优化提升Claude的安全对齐能力,同时保持通用能力,并在保留基准上验证泛化性。
这篇文章最值得关注的要点是什么?
Anthropic通过爬山式优化提升Claude的安全对齐能力,同时保持通用能力,并在保留基准上验证泛化性。;原贴提到:Claude “hill-climbed” safety benchmarks for common misalignments like de;来源:x.com
这篇文章和哪些AI专题相关?
它适合放在AI日报、AI工具、Agent工作流专题里阅读。 关联原因:这篇内容命中「热点解读」等主题信号。;这篇内容命中「Claude」等主题信号。;这篇内容来自该专题长期覆盖的栏目。
阅读这篇文章建议先理解哪些关键词?
建议先理解AI日报、每日AI日报、AI信号、热点解读、BuilderPulse这些关键词,再结合正文判断工具、机会或风险是否值得进入自己的工作流。